

ธุรกิจไอที
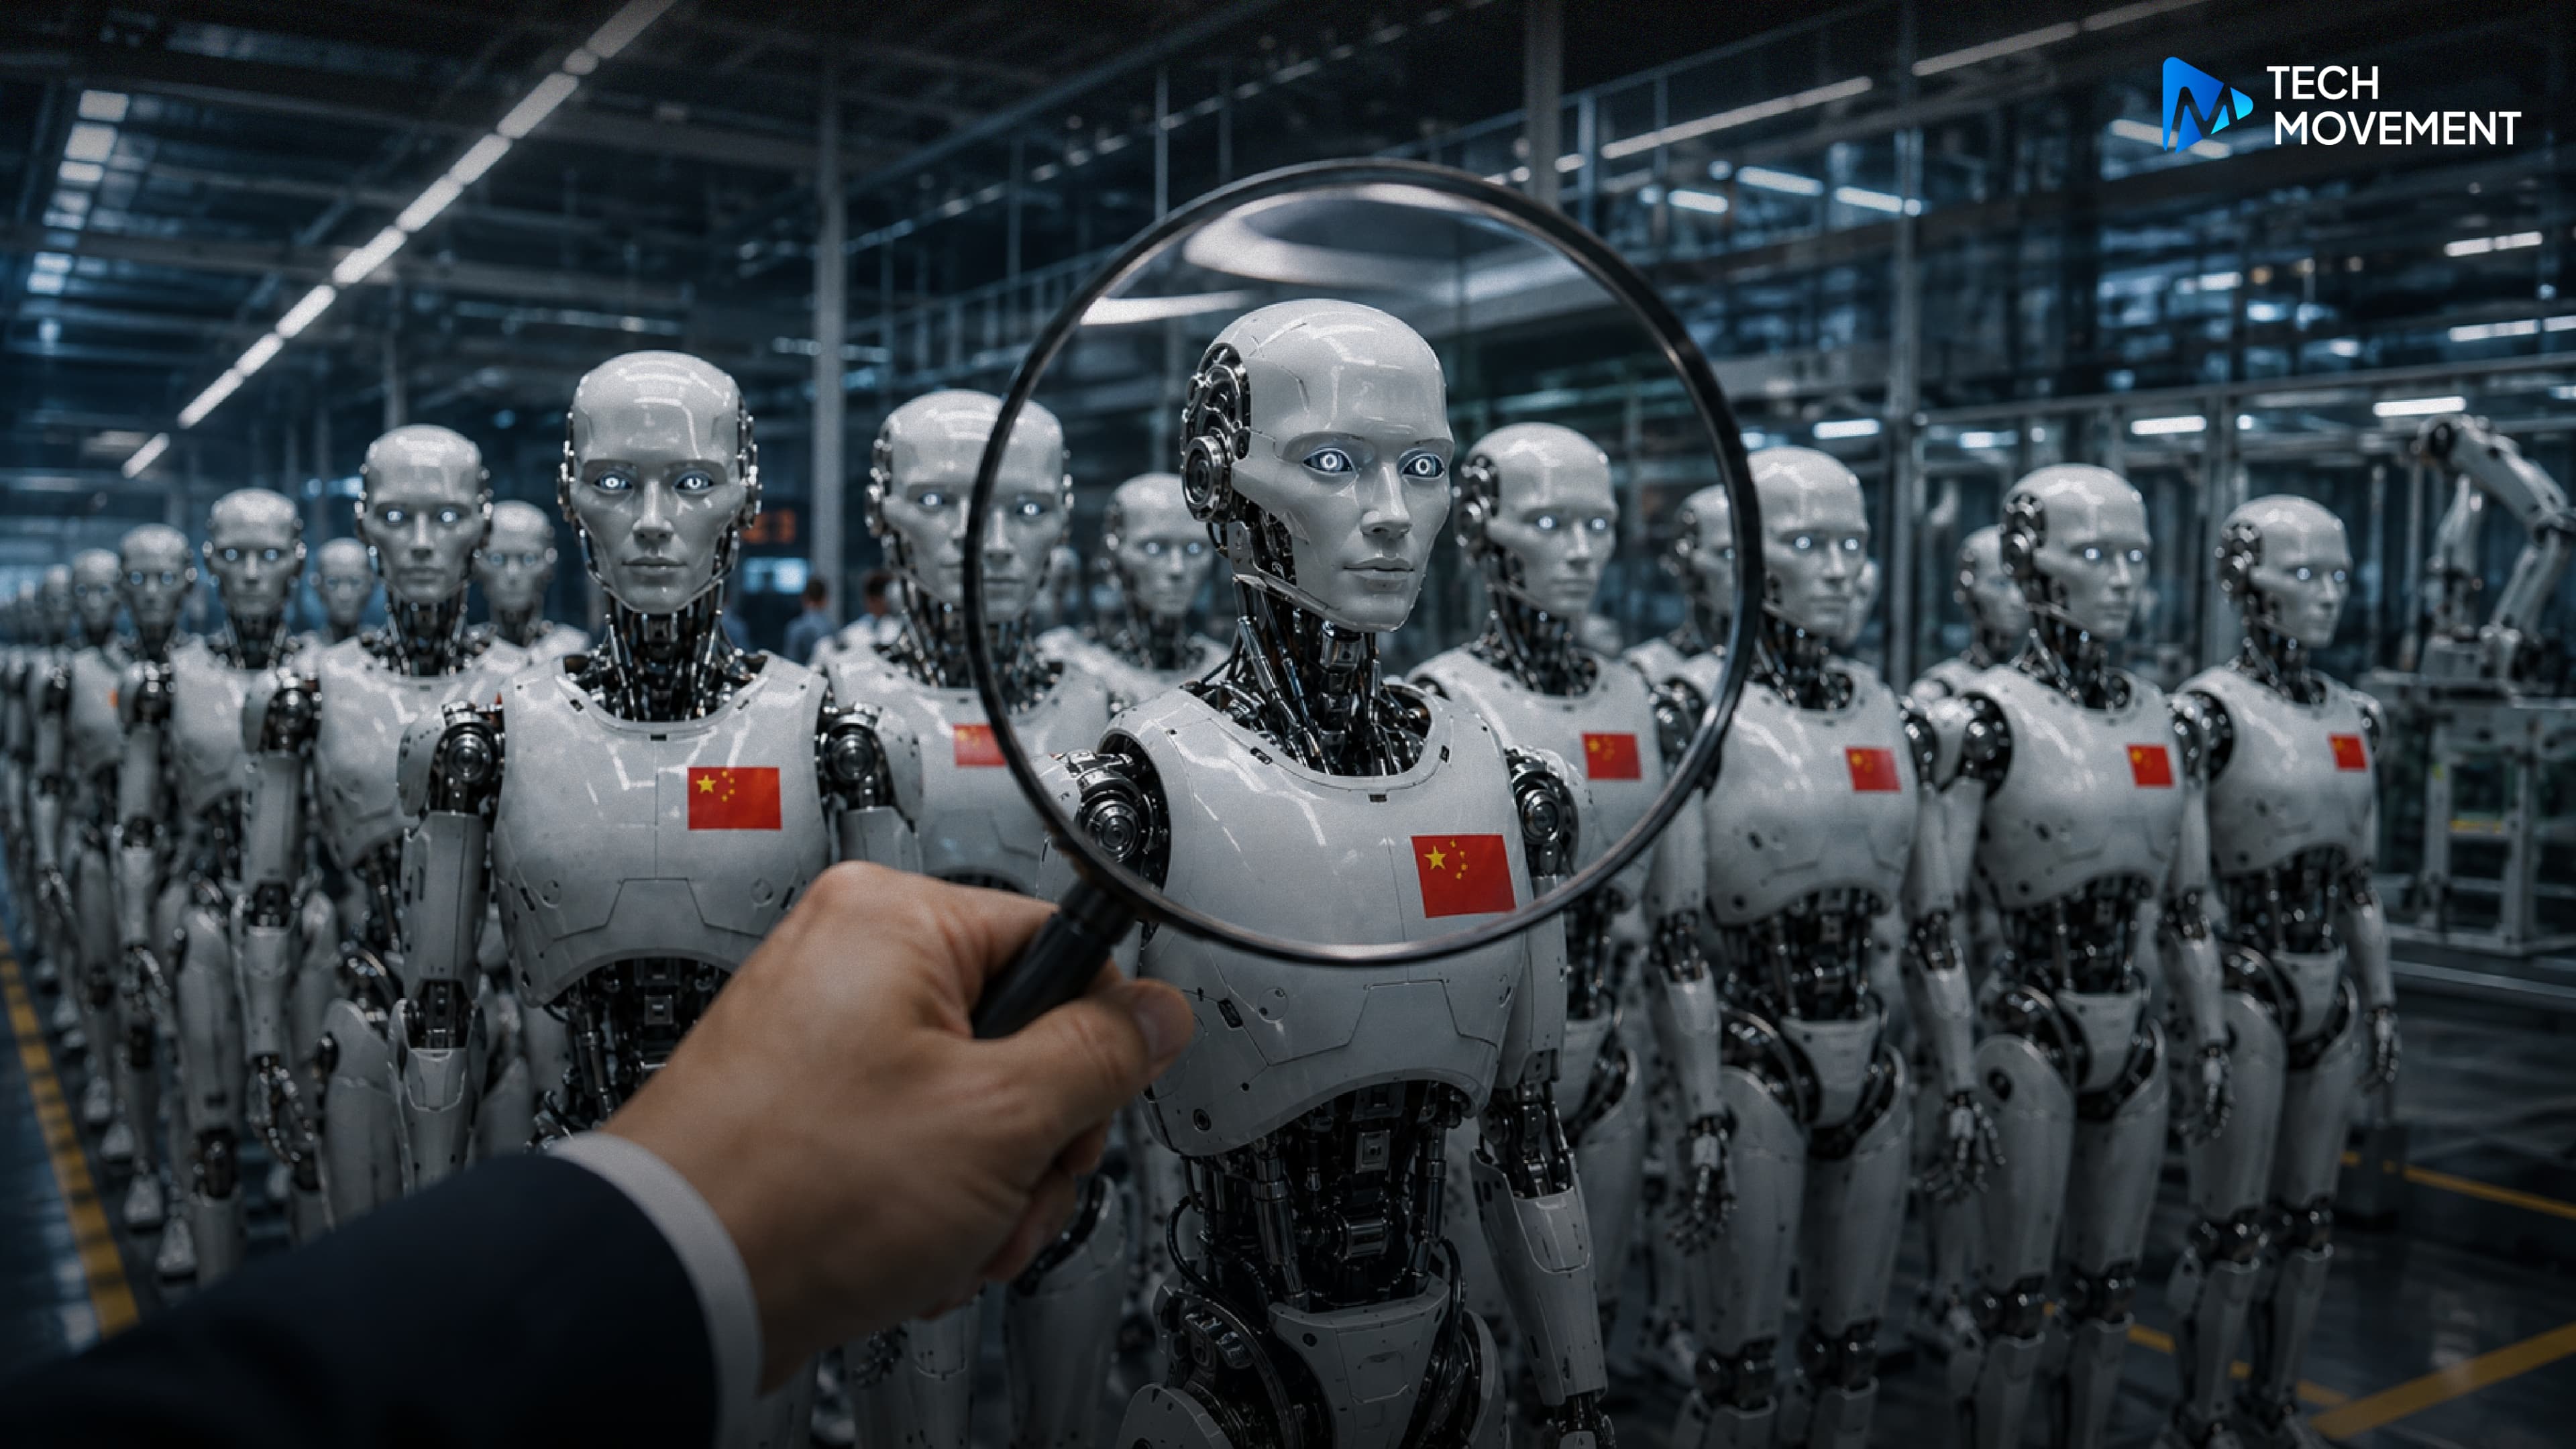
ส่องเบื้องหลังหุ่นยนต์ฮิวแมนนอยด์จีน ทำไมยังห่างไกลจากการแทนที่แรงงานมนุษย์?

30 สิงหาคม 2569
ภาพหุ่นยนต์ฮิวแมนนอยด์จีนโชว์ท่าเต้น ต่อยมวย หรือแม้แต่ตีลังกา กลายเป็นคอนเทนต์ไวรัลที่เราเห็นกันจนคุ้นตาบนโซเชียลมีเดียในช่วงที่ผ่านมา หลายคนอาจเริ่มเชื่อว่าอนาคตที่หุ่นยนต์เข้ามาแทนที่แรงงานมนุษย์ในโรงงานกำลังใกล้เข้ามาทุกที แต่ความเป็นจริงในสายการผลิตกลับสวนทางกับภาพที่เห็นในคลิปไวรัลอย่างสิ้นเชิง
รายงานเชิงลึกจาก Reuters ที่ลงพื้นที่สำรวจโรงงาน ศูนย์ฝึกหุ่นยนต์ และพูดคุยกับผู้บริหารกว่า 40 คนในอุตสาหกรรม เผยให้เห็นว่าเบื้องหลังความยิ่งใหญ่ของอุตสาหกรรมหุ่นยนต์จีน ยังมีช่องว่างขนาดใหญ่ระหว่าง "ความทะเยอทะยานของรัฐบาล" กับ "ความสามารถจริงของเทคโนโลยี"
⚫️ หุ่นยนต์ทำตามได้ แต่ยังคิดเองไม่ได้?
ที่ศูนย์ฝึกแห่งหนึ่งของจีน หุ่นยนต์กว่า 100 ตัวถูกฝึกให้ทำงานพื้นฐานอย่างจัดเรียงลังหรือชงกาแฟ แต่ผู้ฝึกต้องลองถึง 300 ครั้ง กว่าจะได้ท่าที่ใช้งานได้จริง แม้ผู้ฝึกมากประสบการณ์ก็ยังต้องใช้ความพยายามถึง 1 ใน 50 ครั้ง
ขนาดคนในวงการยังพูดตรงๆ ว่า "หุ่นยนต์ยังฉลาดไม่พอ" ปัญหาอยู่ที่ "สมอง" ของหุ่นยนต์ที่ยังปรับตัวไม่เป็น พอเจอเรื่องที่ไม่เคยฝึกมาก่อนก็มักจะทำพลาด
⚫️ ผลิตได้มาก แต่ตลาดยังตามไม่ทัน
การเติบโตของอุตสาหกรรมนี้มาจากแรงหนุนภาครัฐเป็นหลัก ไม่ใช่ความต้องการจากตลาดจริง หน่วยงานรัฐจีนใช้เงินซื้อหุ่นยนต์และอุปกรณ์เกี่ยวข้องมากกว่า 230 ล้านดอลลาร์ในครึ่งปีแรก เพิ่มขึ้นหลายเท่าตัวจากปีก่อน ปัจจุบันจีนมีบริษัทหุ่นยนต์ฮิวแมนนอยด์กว่า 150 แห่ง มากกว่าจำนวนแบรนด์รถ EV เสียอีก
โดยกลยุทธ์นี้คล้ายกับที่จีนเคยใช้กับรถ EV และโซลาร์เซลล์ คือการทุ่มอุดหนุน เพื่อสร้างกำลังผลิตล่วงหน้า แล้วปล่อยให้แข่งขันดุเดือดจนราคาร่วง
⚫️ หุ่นยนต์พร้อมแค่ไหนสำหรับโลกการทำงาน?
โรงงานรถ EV ของ Xiaomi ในปักกิ่งใช้ระบบอัตโนมัติถึง 91% ของขั้นตอนประกอบรถ ด้วยแขนกลอุตสาหกรรมกว่า 700 ตัว ขณะที่หุ่นยนต์ฮิวแมนนอยด์ในโรงงานเดียวกันยังอยู่ขั้นฝึกงานง่ายๆ อย่างขันน็อต แม้แต่ Geely ที่ร่วมมือกับ UBTech ก็ยอมรับว่างานสำคัญบนสายการผลิตยังต้องพึ่งแขนกลเป็นหลักอยู่ดี
สาเหตุคือ "โมเดลสมอง" ของหุ่นยนต์ (vision-language-action model) ซับซ้อนกว่าโมเดลภาษาอย่าง ChatGPT มาก เพราะต้องแปลงข้อมูลภาพเป็นการเคลื่อนไหวที่แม่นยำ และต้องอาศัยชั่วโมงฝึกฝนในสถานการณ์จริงมหาศาล นักวิจัยระบุว่าปัญหาที่เคยอยู่ระดับ "10 เซนติเมตรสุดท้าย" ตอนนี้ลงลึกไปถึง "1 มิลลิเมตรสุดท้าย" ที่ยังแก้ไม่ได้
⚫️ “ข้อมูล” วัตถุดิบที่ยังขาดแคลน
หัวใจของหุ่นยนต์ฮิวแมนนอยด์ไม่ใช่เพียงตัวเครื่อง แต่คือโมเดล Vision-Language-Action (VLA) ที่ต้องเรียนรู้จากภาพ การเคลื่อนไหว และปฏิสัมพันธ์กับวัตถุจริง
ผู้เชี่ยวชาญประเมินว่า ปัจจุบันอุตสาหกรรมมีข้อมูลฝึกคุณภาพสูงเพียง 500,000 ชั่วโมง แต่ต้องการมากถึง 100 ล้านชั่วโมง เพื่อให้หุ่นยนต์มีความฉลาดทางกายภาพในระดับใช้งานทั่วไป
นั่นหมายความว่า ต่อให้จีนเพิ่มจำนวนหุ่นยนต์หรืออัดเงินลงทุนมากเพียงใด ก็ไม่สามารถเร่งกระบวนการเรียนรู้ให้ข้ามข้อจำกัดนี้ได้ในเวลาอันสั้น นี่คือเหตุผลที่บริษัทต่างๆ ยอมผลิตหุ่นยนต์ออกมาเยอะๆ ทั้งที่ยังไม่ทำกำไร เพราะเป้าหมายจริงคือเก็บข้อมูลไปพัฒนา AI ให้เก่งขึ้นในระยะยาว
โดยรวม การแข่งขันที่ดุเดือดทำให้ราคาหุ่นยนต์ร่วงลงเร็ว เช่น หุ่นยนต์ Kuavo ราคาลดลงถึง 26% ในปีเดียว นักลงทุนและผู้ก่อตั้งหลายรายเริ่มยอมรับว่าอุตสาหกรรมนี้กำลังเข้าสู่ภาวะฟองสบู่ และคาดว่าจะเริ่มมีการควบรวมกิจการครั้งใหญ่ช่วงปลายปี 2026-2027
แม้จีนจะมีโอกาสครองความได้เปรียบด้านห่วงโซ่อุปทานหุ่นยนต์ระดับโลก แต่หุ่นยนต์เหล่านี้ยังทำงานได้เพียงราว 20% ของความเร็วมนุษย์ ซึ่งอาจยังไม่ใช่คู่แข่งของมนุษย์ โดยตรง คำถามสำคัญจึงไม่ใช่ว่าจีนผลิตหุ่นยนต์ได้เร็วแค่ไหน แต่คือเมื่อไหร่หุ่นยนต์เหล่านี้จะ "ฉลาดพอ" ที่จะสร้างมูลค่าจริงในโลกการทำงาน
ซึ่งนี่อาจเป็นโจทย์ใหญ่สำหรับผู้พัฒนาในหลายประเทศว่า ใครจะสามารถพัฒนาหุ่นยนต์ให้ก้าวข้ามข้อจำกัดด้านความฉลาดและความแม่นยำ จนสามารถทำงานได้จริงและสร้างมูลค่าในเชิงพาณิชย์ได้ก่อนกัน
ข่าวที่เกี่ยวข้อง
Server เสียน้อยลง 8 เท่า แต่ไม่คุ้มขยายต่อ? เจาะเหตุผลที่ Microsoft ยุติ Data Center ใต้ทะเล
หากพูดถึง Data Center ทุกคนมักนึกถึงภาพของอาคารขนาดใหญ่ที่เต็มไปด้วย Server และระบบระบายความร้อนที่ต้องทำงานตลอด 24 ชั่วโมง แต่ Microsoft ได้ใช้วิธีจัดการกับความร้อน ด้วยการทดลองนำ Data Center ลงไปไว้ใต้ทะเล ผ่านโครงการ Project Natick ที่เริ่มศึกษาในปี 2013
 2 วันที่แล้ว
Server เสียน้อยลง 8 เท่า แต่ไม่คุ้มขยายต่อ? เจาะเหตุผลที่ Microsoft ยุติ Data Center ใต้ทะเล
2 วันที่แล้ว
สิงคโปร์ เตือน! AI แย่งงานบัณฑิตจบใหม่ ชี้ภาครัฐ-การศึกษาต้องเร่งปรับตัว
2 วันที่แล้ว
แว่น Meta กับประเด็นที่ชวนคิด หรือว่าเทคโนโลยีกำลังมีส่วนทำให้พื้นที่ส่วนตัวหายไป?
2 วันที่แล้ว